Resumen rápido
Tu agente funciona con saldo, y lo que más influye en cuánto gasta es qué "cerebro" (modelo de IA) usa para cada tarea. Con la configuración recomendada no tienes que tocar nada — esta guía es para cuando quieras entender el detalle y sacarle más partido.
Qué es el saldo y por qué se gasta
Cada vez que hablas con tu agente — le pides algo, te responde, revisa tu correo, redacta un texto, toca tu web — está usando inteligencia artificial, y eso tiene un coste. Ese coste se descuenta de tu saldo.
No todas las tareas gastan lo mismo: un resumen corto gasta céntimos; analizar 50 documentos gasta más. Y hay dos cosas que marcan la diferencia de verdad: qué modelo de IA usa y cuánto trabajo interno le lleva la tarea. Vamos con las dos.
Tokens: la unidad en la que se mide todo
Las IAs no cobran por mensaje ni por minuto: cobran por token. Un token es un trocito de palabra — como regla fácil, un token ≈ ¾ de una palabra.
Para hacerte una idea con cosas de cada día:
| Texto | Tokens aprox. |
|---|---|
| Un "hola, ¿me resumes esto?" | 10 |
| Un correo normal | 400–600 |
| Una página de texto | 700 |
| Un contrato de 20 páginas | 14.000 |
| Una novela entera | 150.000 |
| Un millón de tokens | unas 1.500 páginas — 6 o 7 novelas |
Y hay dos tipos, porque leer y escribir no cuestan lo mismo:
- Tokens de entrada (input): todo lo que el modelo lee — tu mensaje, los documentos que le pasas, la conversación anterior que necesita recordar.
- Tokens de salida (output): todo lo que el modelo escribe. Escribir es más caro que leer — mira la tabla del final: la columna de salida siempre es varias veces la de entrada.
Una orden tuya = decenas de peticiones a la IA
Aquí está la clave que casi nadie explica. Cuando le pides algo a tu agente, no hace una única consulta a la IA. Trabaja como lo haría un asistente de verdad:
- Entiende lo que le pides y decide si le falta información
- Planifica los pasos: qué mirar, en qué orden, con qué herramienta
- Ejecuta cada paso: consulta tu correo, tu web, busca en internet…
- Revisa cada resultado y corrige si algo no salió como esperaba
- Redacta la respuesta final que tú ves
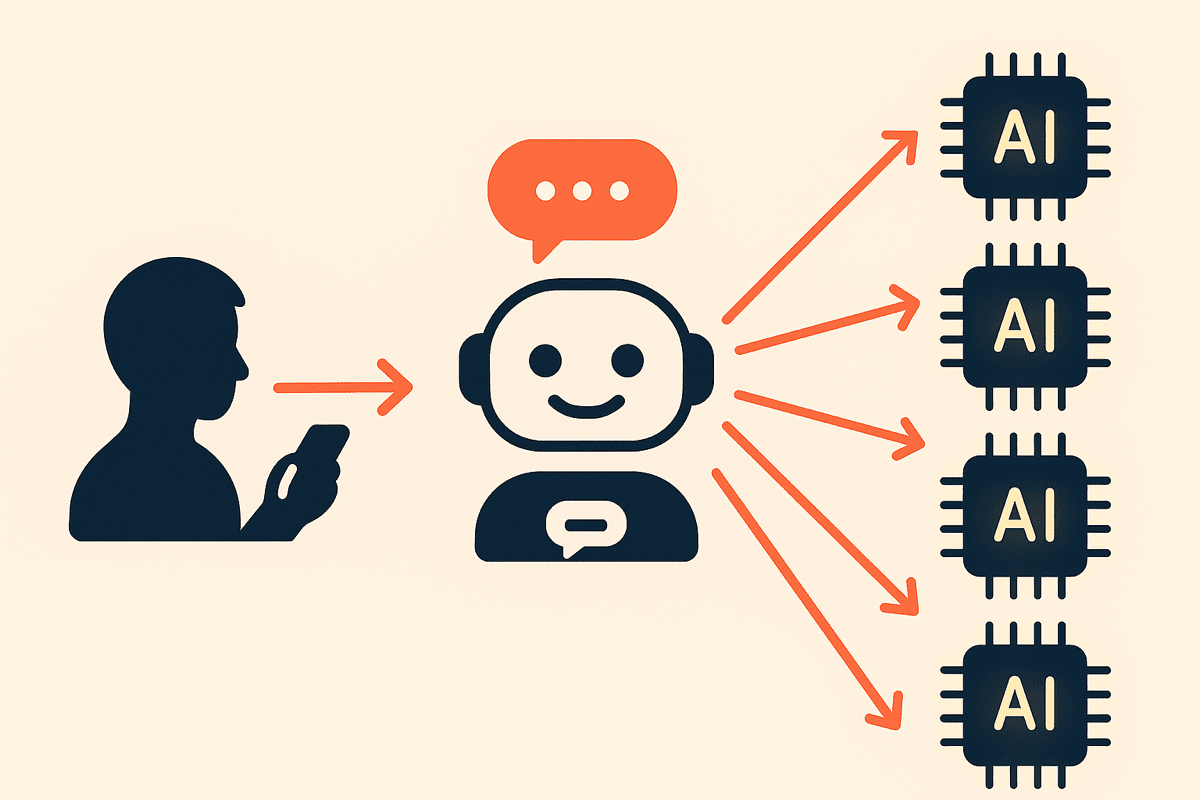
Cada uno de esos pasos es una petición a la IA. Una orden sencilla ("resúmeme este texto") puede resolverse en un par de peticiones. Una tarea compleja ("revisa mi web y arregla lo que esté roto") puede generar decenas o incluso cientos de peticiones: el agente va tomando decisiones, probando, comprobando y corrigiendo hasta terminar.
Esto explica dos cosas que al principio sorprenden:
- En
 ver en qué se gasta aparecerán muchas más peticiones que mensajes le has escrito. Es normal: es tu agente pensando y trabajando por ti.
- Una tarea con una respuesta corta puede gastar más que un texto largo. Lo que cuesta no es el texto final — es todo el trabajo de decidir cómo llegar hasta él.
Y una consecuencia importante: como cada tarea genera muchas peticiones internas, el modelo que tengas de habitual multiplica su efecto. Elegir bien el modelo del día a día es la decisión que más saldo te ahorra, con diferencia.
Los enlaces con el avión de hablo se abren dentro de tu agente — solo funcionan si ya eres usuario de hablo.Cómo ver tu saldo y en qué se va
Si eres usuario de hablo, tienes dos accesos directos desde Telegram:
El segundo te muestra en qué peticiones y en qué IAs se está gastando tu saldo. Si algún día baja más rápido de lo normal, ahí verás por qué.
El único consejo que necesitas: GPT 5.4
Tu agente puede usar muchos modelos distintos, pero no hace falta que los conozcas. GPT 5.4 es el que recomendamos para el día a día: el mejor en relación coste-resultado. Y como acabamos de ver, ese modelo habitual se usa en decenas de peticiones internas por tarea — con él, tu saldo rinde.
¿Y si una tarea se le resiste? Sube de modelo — solo para esa tarea
A veces notarás que con algo concreto el agente no termina de aclararse: repite, se lía, o el resultado no convence. Para esos casos hay modelos más potentes, que piensan mejor a cambio de gastar más:
- GPT 5.5 o GPT 5.6 Sol (OpenAI)
- Grok (xAI)
El cambio de modelo lo haces tú, en un momento: escribe /models a tu agente en Telegram y elige el modelo de la lista, o selecciónalo desde la interfaz web. El modelo elegido queda activo hasta que lo vuelvas a cambiar.
Y una recomendación concreta: si tu agente está haciendo trabajo delicado o crítico — cambios en tu web, tocar cosas que no pueden romperse, tareas de programación — merece la pena pedirle GPT 5.6 Sol o GPT 5.6 Terra: es donde más compensa pagar por precisión, porque un error ahí sale mucho más caro que unos tokens de más.
El truco siempre es el mismo: cambia a un modelo potente para esa tarea, y cuando termines vuelve a poner GPT 5.4 para el día a día.
Los modelos que suenan a chino (Llama, DeepSeek, Qwen, Kimi…)
Verás que hay muchos más modelos disponibles. Si no sabes por qué usarías uno de ellos, no te van a salir a cuenta: para el uso cotidiano los notarás más torpes, repetirás peticiones y acabarás gastando más. Probarlos por curiosidad no hace daño; quedarte en ellos sin motivo, sí.
No solo texto: imágenes, vídeo, voces y audio
Tu agente no solo escribe. También puede usar IAs de otro tipo: generar y editar imágenes, crear vídeos, poner voz a un texto o incluso clonar una voz.
Estas IAs no se miden en tokens: se cobran por unidad — por imagen generada, por segundo de audio o de vídeo. Como referencia rápida: una imagen suele costar unos céntimos; el vídeo y la clonación de voz están entre lo más caro que puede hacer tu agente.
No pasa nada por usarlas — para eso están — pero conviene saberlo: son las tareas que más saldo mueven de golpe, y salen del mismo saldo que todo lo demás.
Tabla de precios, por si te gusta el detalle
Precios en euros por cada millón de tokens (recuerda: un millón ≈ 1.500 páginas):
| Modelo | Entrada (€) | Salida (€) |
|---|---|---|
| gpt-5.4 ⭐ recomendado | 0,50 | 3,00 |
| nemotron-ultra-253b | 0,60 | 3,00 |
| qwen3-coder-plus | 0,65 | 3,25 |
| kimi-k2.6 | 0,66 | 3,41 |
| gpt-5.6-terra | 0,70 | 4,00 |
| gpt-5.5 | 1,00 | 5,00 |
| mistral-large-3-675b | 1,00 | 5,00 |
| qwen3.5-397b | 1,00 | 5,00 |
| gpt-5.6-luna-pro | 1,00 | 6,00 |
| gpt-5.6-sol | 1,20 | 6,00 |
| grok-4.20 (non-reasoning) | 1,25 | 2,50 |
| grok-4.20 (reasoning) | 1,25 | 2,50 |
| grok-4.3 | 1,25 | 2,50 |
| qwen3.7-max | 1,25 | 3,75 |
| deepseek-v4-pro | 1,74 | 3,48 |
| mistral-large | 2,00 | 6,00 |
| claude-opus-4.8 | 5,00 | 25,00 |
| claude-fable-5 | 10,00 | 50,00 |
Del más económico al más caro hay 20 veces de diferencia — y recuerda el multiplicador: cada tarea son decenas de peticiones. Por eso el modelo habitual importa más que ninguna otra cosa.
En resumen
- Deja GPT 5.4 como modelo habitual — cubre el 90% de lo que haces.
- Tarea difícil → cambia con /models a un modelo potente (GPT 5.5, Grok) solo para esa tarea, y vuelve al habitual al terminar.
- Trabajo crítico (tu web, programación, cambios delicados) → GPT 5.6 Sol o Terra.
- Imágenes, vídeo y voz: úsalas sabiendo que son el gasto grande.
- Consulta tu saldo y en qué se gasta cuando quieras — sin sorpresas.
Preguntas frecuentes
¿Cómo sé cuánto saldo me queda?
Si eres usuario de hablo, tócalo directamente en Telegram: ver mi saldo actual.
¿Por qué veo muchas más peticiones que mensajes he enviado?
Porque cada orden tuya se convierte, por dentro, en varias peticiones a la IA: entender, planificar, ejecutar, revisar y redactar. Es tu agente trabajando por ti — cuantos más pasos tiene la tarea, más peticiones verás.
¿Qué modelo me recomendáis para el día a día?
GPT 5.4. Es el mejor en relación coste-resultado y cubre la gran mayoría de las tareas cotidianas. Solo merece la pena subir de modelo para tareas difíciles o trabajo crítico.
¿Cómo cambio de modelo? ¿Se queda para siempre?
Se cambia en un momento: escribe /models a tu agente en Telegram y elige de la lista, o selecciónalo desde la interfaz web. El modelo queda activo hasta que lo cambies otra vez — para una tarea puntual, cámbialo, termina la tarea y vuelve a dejar GPT 5.4.
¿Generar imágenes, vídeo o voz gasta mucho?
Se cobra por unidad (por imagen, por segundo de audio o vídeo), no por tokens. Una imagen suele costar unos céntimos; el vídeo y la clonación de voz son de lo más caro que puede hacer tu agente. Úsalos sabiendo que son el gasto grande.